Разбор · ChatGPT
Налог на русский: сравниваем расход токенов на четырёх языках
Начальный уровень
Увидела ролик: общаться с ChatGPT по-русски дороже, чем по-английски. То есть за родной язык ещё и доплачивать? Пошла проверять. Взяли три коротких текста, добавили хинди и китайский и посчитали токены двумя способами. Разница оказалась занятнее самого «налога». Заодно выяснила, когда появился новый словарь и можно ли выбрать его вручную.
Содержание статьи
За что здесь вообще предлагают доплачивать?
Нейросеть разбивает текст на небольшие части, токены. В один токен может поместиться слово, часть слова или знак препинания. Пробелы тоже участвуют в разбиении. Поэтому число слов и число токенов не совпадают.
Если сервис берёт деньги за токены, более длинная последовательность при той же цене за токен обходится дороже. Отсюда и разговорный «налог на язык». Отдельного сбора за русский здесь нет. В обычной подписке ChatGPT каждый русский запрос не превращается в отдельную платёжку.
Мы считаем, сколько токенов занимает исходный текст на каждом языке. Ответ нейросети, историю переписки и полный счёт за работу здесь не измеряем. Как OpenAI различает входные, выходные и другие токены, объяснено в официальной справке.
Какие тексты сравниваем
Начали с обычной фразы: «Встреча начнётся завтра в десять утра». Затем добавили просьбу написать письмо клиенту и просьбу пересказать статью. Для каждого текста подготовили английскую, русскую, китайскую версии и версию на хинди, одном из языков Индии.
Смысл старались сохранить, а число букв специально не выравнивали. Переводы подготовлены с помощью ИИ, без независимой проверки носителями. Это небольшой опыт на трёх примерах, по нему нельзя составить рейтинг всех языков.
Считали каждую строку отдельно официальной библиотекой OpenAI tiktoken, версия 0.14.0. Потом складывали три результата. Исходные формулировки и результаты оставили в конце разбора.
Русский занял вдвое больше токенов. Хинди вчетверо
Первый подсчёт сделали кодировкой, которая используется у GPT-4. Её название: cl100k_base. Английские версии трёх текстов заняли 48 токенов. Русские 96. Хинди 192.

Ничего себе, поговорили. Содержание примерно одинаковое, а на хинди ушло в четыре раза больше токенов, чем на английском. Но результат зависит не только от языка. Имеет значение, какой набор токенов использует выбранная модель.
Когда старый словарь сменился на новый?
Точной даты общей замены нет, потому что OpenAI не переключила все модели с одного словаря на другой. Кодировки существуют параллельно: GPT-4 использует cl100k_base, а GPT-4o использует o200k_base.
Новая кодировка появилась вместе с GPT-4o, который OpenAI представила 13 мая 2024 года. В анонсе компания отдельно показала, что новый токенизатор сильнее сокращает тексты на языках, отличных от английского: для русского в примере OpenAI число токенов уменьшилось с 39 до 23, для хинди с 90 до 31.
У cl100k_base 100 256 обычных фрагментов, у o200k_base 199 998. Служебные токены в эти числа не входят. Это не количество слов русского или английского языка. В набор входят части слов, знаки и фрагменты разных языков.
В ChatGPT отдельного переключателя словаря нет: кодировку определяет выбранная модель. Для ручного сравнения можно открыть независимый Tiktokenizer и выбрать в правом верхнем углу cl100k_base или o200k_base. В библиотеке tiktoken эти же кодировки выбираются по имени. Соответствие моделей и кодировок записано в коде OpenAI.
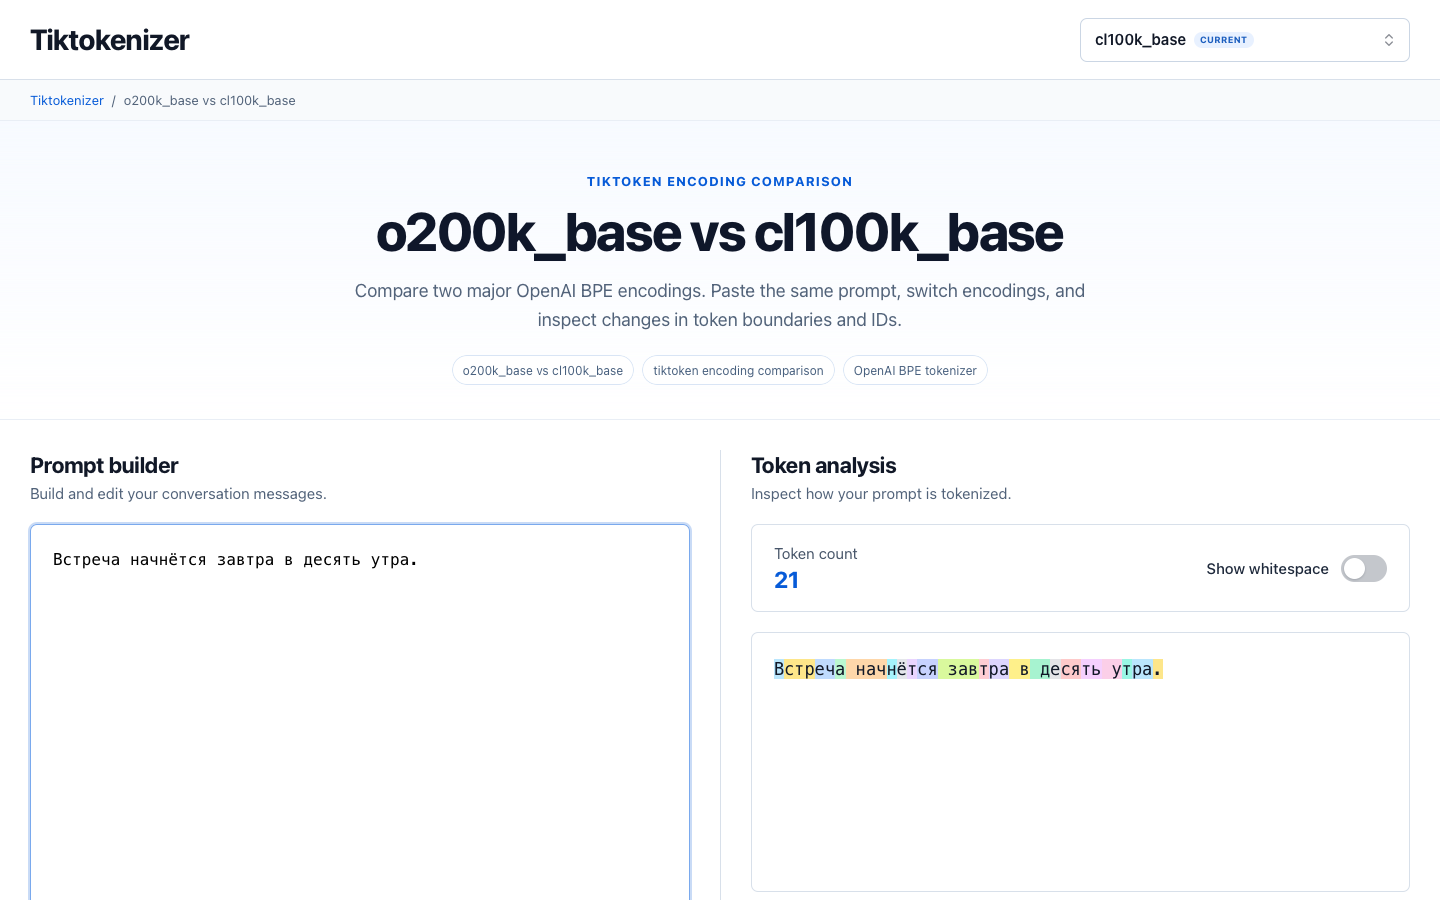
cl100k_base: 21 токен. Скриншот Tiktokenizer от 14 октября 2026 года.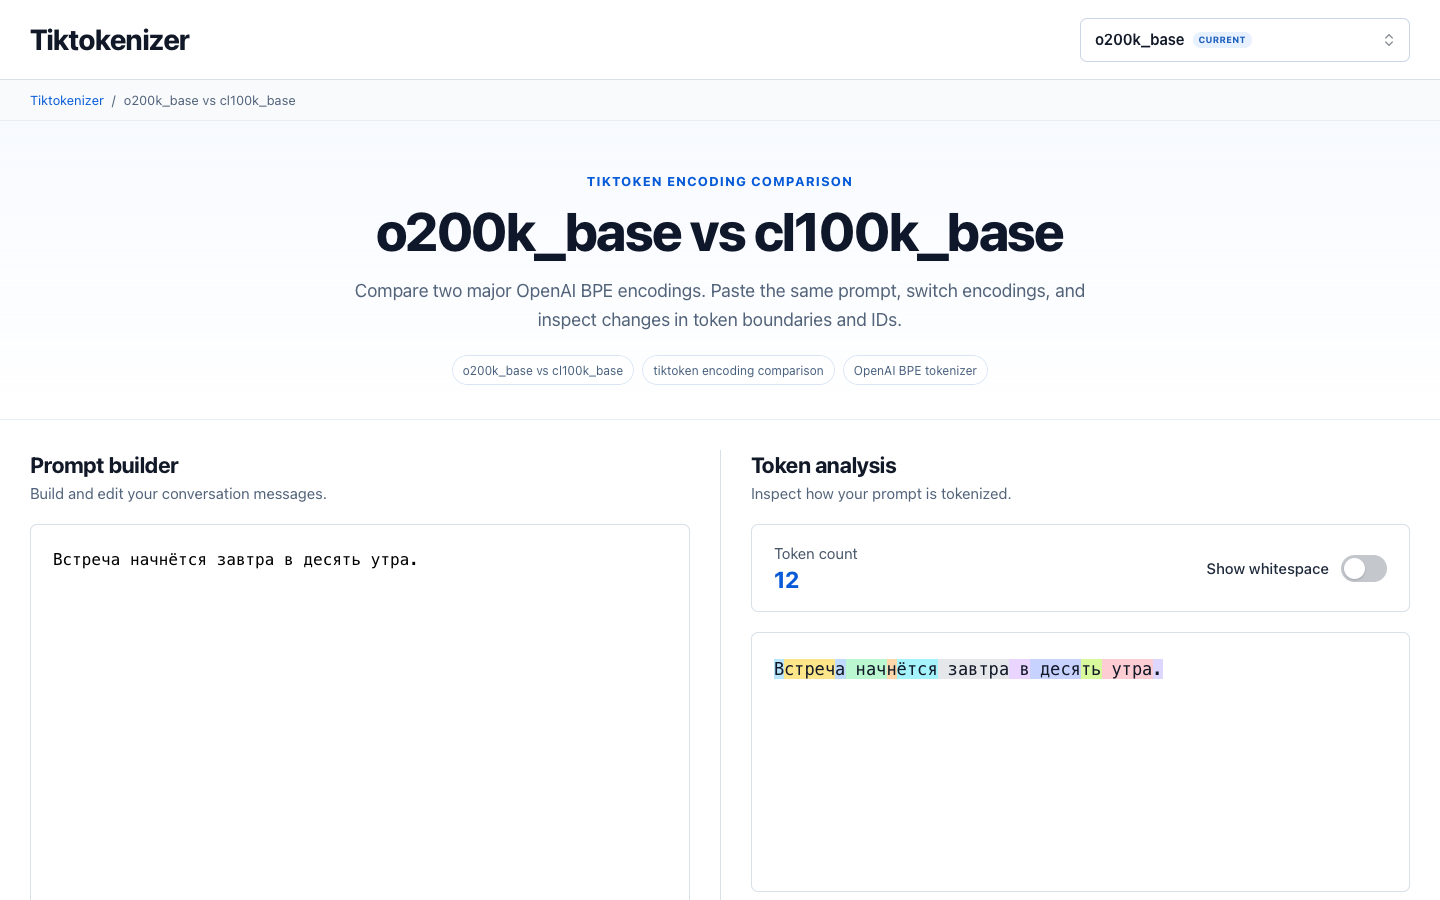
o200k_base: 12 токенов. Кодировка выбрана вручную в правом верхнем углу.Tiktokenizer не принадлежит OpenAI. Он показывает точное разбиение открытых кодировок tiktoken прямо в браузере. Итоговые числа дополнительно сверены локально официальной библиотекой OpenAI.
Меняем кодировку. Тексты оставляем теми же
Теперь считаем те же строки способом GPT-4o. Английский остался на 48 токенах. Русский уменьшился до 56, хинди до 62. Ни слова в исходных примерах мы для этого не меняли.

В первом подсчёте на русский ушло вдвое больше токенов, чем на английский. Во втором разница сократилась до восьми токенов. Поэтому даже для этих трёх текстов нельзя назвать одну постоянную «наценку» за язык.
А китайский тоже доплачивает?
Смотришь на иероглифы, между словами даже привычных пробелов нет. Кажется, здесь-то наверняка всё сложно. Только счётчик оценивает текст совсем не так, как человек, который не знает китайского.
В старом наборе китайские версии заняли 60 токенов. В новом всего 41 токен против английских 48. В этих трёх примерах китайский оказался компактнее английского.

Всё, учим китайский? Учебник пока отложи. Мы не проверяли, как перевод повлияет на качество ответа, и не считали стоимость полного диалога. Расход по внешнему виду текста не угадаешь. Зато свой конкретный запрос можно посчитать.
Как проверить свой текст
Открыть сравнение двух кодировок
- Вставь свой текст в поле слева.
- Выбери в правом верхнем углу
o200k_baseдля GPT-4o илиcl100k_baseдля GPT-4. - Если сравниваешь языки, вставь перевод того же текста и не меняй кодировку между подсчётами.
- Смотри не только на число, но и на цветные фрагменты: они показывают, где текст разделился на токены.
Это число относится к введённому тексту, а не ко всему диалогу. В платном API отдельно считаются входные и выходные токены, а сообщения могут получать служебную обвязку. Поэтому маленькое число в визуализаторе не гарантирует маленький счёт за всю задачу.
Исходные данные опыта
Ниже оставлены точные формулировки и результаты, чтобы было видно, что именно сравнивалось. Для своей работы вставь в счётчик собственный запрос.
Сообщение о встрече
Английский · GPT-4: 10 · GPT-4o: 10.
The meeting starts tomorrow at ten in the morning.Русский · GPT-4: 21 · GPT-4o: 12.
Встреча начнётся завтра в десять утра.Хинди · GPT-4: 35 · GPT-4o: 10.
बैठक कल सुबह दस बजे शुरू होगी।Китайский · GPT-4: 10 · GPT-4o: 8.
会议明天上午十点开始。Письмо клиенту
Английский · GPT-4: 16 · GPT-4o: 16.
Write a short email to the client and ask them to confirm the meeting time.Русский · GPT-4: 32 · GPT-4o: 15.
Напиши короткое письмо клиенту и попроси подтвердить время встречи.Хинди · GPT-4: 68 · GPT-4o: 24.
ग्राहक को एक छोटा ईमेल लिखो और उससे बैठक का समय पक्का करने के लिए कहो।Китайский · GPT-4: 21 · GPT-4o: 15.
给客户写一封简短的邮件,请他确认会议时间。Пересказ статьи
Английский · GPT-4: 22 · GPT-4o: 22.
Summarize this article in three sentences. Keep the main facts and do not add anything of your own.Русский · GPT-4: 43 · GPT-4o: 29.
Перескажи эту статью в трёх предложениях. Сохрани основные факты и ничего не добавляй от себя.Хинди · GPT-4: 89 · GPT-4o: 28.
इस लेख का सार तीन वाक्यों में लिखो। मुख्य तथ्यों को बनाए रखो और अपनी ओर से कुछ मत जोड़ो।Китайский · GPT-4: 29 · GPT-4o: 18.
用三句话总结这篇文章。保留主要事实,不要添加自己的内容。Что ещё обычно путают
ChatGPT переводит русский на английский, поэтому токенов больше?
Наш подсчёт этого не показывает. Токенизация разбивает исходный текст на фрагменты. Из разницы чисел нельзя сделать вывод о внутреннем переводе или о том, на каком языке модель «думает».
На хинди всегда в четыре раза больше токенов?
Нет. Четыре раза получилось для суммы трёх наших текстов в cl100k_base. У тех же текстов в o200k_base соотношение уже 62 к 48. На других формулировках числа тоже могут измениться.
Новая кодировка автоматически делает любую модель дешевле?
Нет. Она может уменьшить число токенов текста, но у моделей разные тарифы и ответы разной длины. Для сравнения цены нужно учитывать всю выполненную задачу.
Проверять стоит свой текст, на той кодировке, которая соответствует выбранной модели. Тогда вместо общего страха про «налог на язык» будет конкретное число для собственной задачи.
Как поручить нейросетям работу над своим проектом?
Что можно делать с нейросетями, если не знаешь кода?
Чтобы почувствовать размах, посмотри Концентрат Ивана Сергеева в записи. ИИ-агенты на твоих глазах собирают продукт, контент, сайты и воронки без кода. Это основа под любую цель: свои услуги, партнёрка, чужой бизнес. Три вечера в записи, промпты и четыре скилла. 990 ₽ один раз. Доступ на 14 дней после оплаты.
Забрать КонцентратУже знаешь, чего хочешь? Тогда в мастер-группу Ивана: система продаж на ИИ без продюсера и технаря, сопровождение и сообщество
Заполнить анкету предзаписиНабор открывается редко, кто записался заранее, получает лучшую цену и бонусы. Платить сейчас не нужно
Реклама. ИП Сергеев И. С., ИНН 352511695540. erid: 2Vtzqwfc8iA